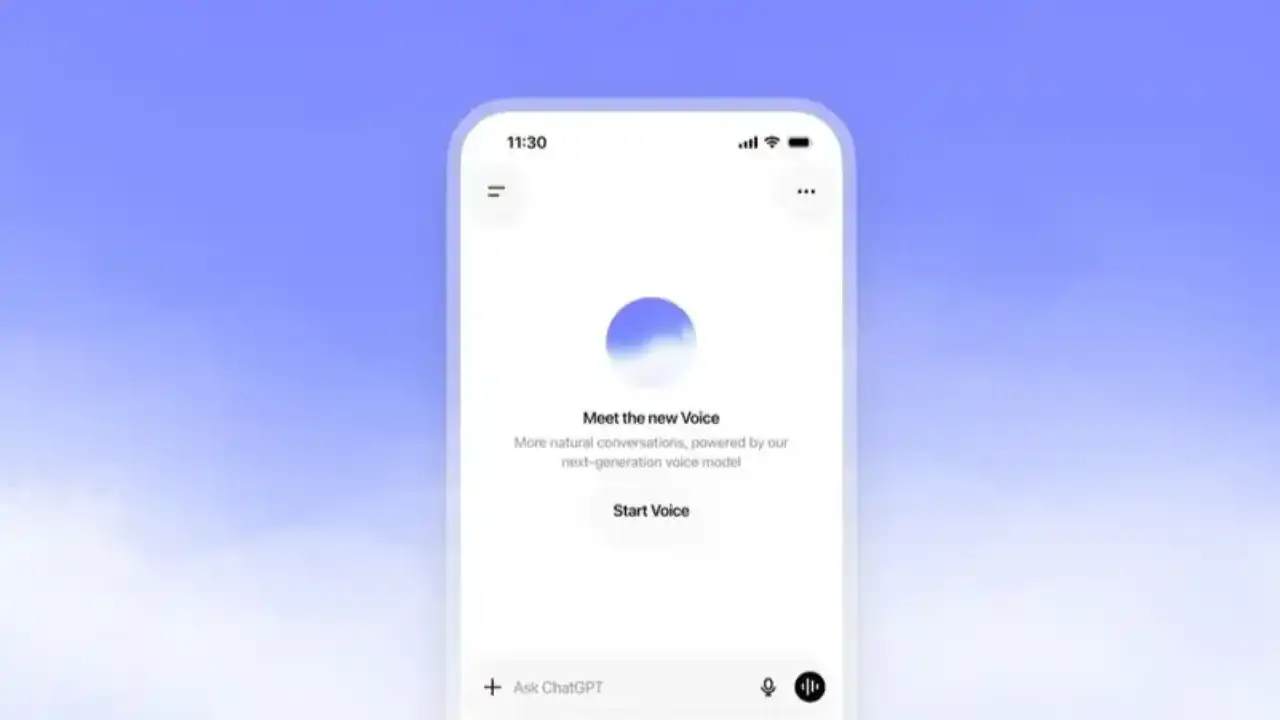
OpenAI تطلق جيلاً جديداً من الذكاء الصوتي لجعل محادثات ChatGPT أكثر طبيعية
كشفت شركة OpenAI عن جيل جديد من نماذج الذكاء الاصطناعي الصوتية يحمل اسم GPT-Live-1 وGPT-Live-1 mini، في خطوة جديدة تهدف إلى تطوير تجربة التفاعل بين الإنسان والآلة، وجعل المحادثات الصوتية عبر ChatGPT أكثر سرعة وواقعية وقرباً من طريقة التواصل البشري.
وتأتي النماذج الجديدة ضمن توجه الشركة لتطوير ما يعرف بـ الذكاء الاصطناعي الصوتي المتقدم (Advanced Voice AI)، بحيث لا يقتصر دور المساعد الذكي على استقبال الأوامر الصوتية والرد عليها، بل يصبح قادراً على فهم السياق الكامل للمحادثة، وإدارة حوار طويل ومتواصل، والتعامل مع المقاطعات والتغييرات المفاجئة في موضوع الحديث.
وأكدت OpenAI أن النماذج الجديدة تعتمد على تقنية Full-Duplex Communication، وهي تقنية تسمح للمساعد الصوتي بالاستماع والتحدث في الوقت نفسه، على غرار المحادثات الطبيعية بين البشر، حيث لم يعد المستخدم مضطراً إلى انتظار انتهاء المساعد من كلامه قبل طرح سؤال جديد أو تصحيح معلومة.
وتُعد هذه التقنية تحولاً مهماً مقارنة بالأنظمة الصوتية التقليدية التي كانت تعتمد على سلسلة من المراحل المنفصلة، تبدأ بتحويل الصوت إلى نص عبر تقنية Speech-to-Text، ثم تحليل النص بواسطة نموذج لغوي Large Language Model (LLM)، وبعد ذلك تحويل الإجابة المكتوبة إلى صوت باستخدام تقنية Text-to-Speech (TTS).
أما النماذج الجديدة فتعمل بطريقة أكثر تكاملاً، إذ تعالج الصوت والمعنى والسياق بشكل متزامن، ما يقلل زمن الاستجابة Latency ويجعل الحوار أكثر انسيابية، ويمنح المستخدم شعوراً بأنه يتحدث مع مساعد يفهم المحادثة بشكل مباشر.
وأعلنت الشركة أن نموذج GPT-Live-1 mini سيكون الوضع الصوتي الافتراضي الجديد داخل تطبيق ChatGPT، بينما سيحصل المشتركون في الخطط المدفوعة على إمكانية الوصول إلى النموذج الأكبر GPT-Live-1 الذي يوفر قدرات أعلى في معالجة المحادثات المعقدة.
وتقول الشركة إن الهدف الأساسي من تطوير هذه النماذج هو تجاوز القيود التي كانت موجودة في الإصدار الصوتي السابق، خصوصاً فيما يتعلق بفهم المقاطعات، والحفاظ على سياق الحوار، والقدرة على التعامل مع الأسئلة التي تحتاج إلى تحليل أعمق.
ومن أبرز التحسينات الجديدة قدرة المساعد على التوقف عن الكلام فور مقاطعة المستخدم، بدلاً من الاستمرار في قراءة الإجابة المسجلة مسبقاً، إضافة إلى قدرته على الاستماع لفترات أطول وفهم متى يحتاج إلى الرد ومتى يجب أن يبقى صامتاً.
ومن بين الاستخدامات التي ركزت عليها OpenAI ميزة الترجمة الفورية المباشرة Real-Time Translation، إذ يمكن للنموذج الجديد المساعدة في إجراء محادثات بين أشخاص يتحدثون لغات مختلفة، مع الحفاظ على تدفق الحوار دون الحاجة إلى التوقف بين كل جملة وأخرى.
كما أصبح النظام قادراً على تقديم تجربة متعددة الوسائط Multimodal AI، حيث لا يقتصر التفاعل على الصوت فقط، بل يمكنه عرض معلومات بصرية أثناء المحادثة، ما يفتح الباب أمام استخدامات جديدة في التعليم، والعمل، وخدمة العملاء، والمساعدة الشخصية.
وأشارت الشركة إلى أن النماذج الجديدة يمكنها الاستفادة من قدرات نماذجها المتقدمة مثل GPT-5.5 لتنفيذ عمليات البحث، والتحليل، والاستدلال، وإنجاز مهام أكثر تعقيداً مع استمرار المحادثة الصوتية دون انقطاع.
وأكدت OpenAI أن النظام الجديد صُمم لدعم المحادثات الطويلة التي تمتد لعشرات الدقائق، مع قدرة أفضل على الاحتفاظ بسياق الحوار Context Awareness.
وأوضح مسؤول منتج ChatGPT Voice أتي إيليتي أن التجارب الداخلية تضمنت محادثات استمرت بين 30 و40 دقيقة أثناء المشي، مشيراً إلى أن الهدف هو تطوير مساعد قادر على مرافقة المستخدم في مهام طويلة دون فقدان تفاصيل الحديث السابق.
وتعتبر هذه القدرة من أبرز التحديات التقنية في مجال الذكاء الاصطناعي الصوتي، إذ إن الحفاظ على ذاكرة المحادثة وفهم التفاصيل السابقة يتطلب أنظمة متقدمة لمعالجة اللغة الطبيعية Natural Language Processing (NLP) وإدارة السياق.
وترى OpenAI أن الصوت قد يصبح خلال السنوات المقبلة الواجهة الرئيسية للتعامل مع أجهزة الحاسوب والأنظمة الرقمية، خصوصاً مع انتشار مفهوم الوكلاء الذكيين AI Agents القادرين على تنفيذ المهام بشكل مستقل بناءً على أوامر المستخدم.
وقال مسؤول المنتج في الشركة إن المستقبل قد يشهد اعتماد المستخدمين على الأوامر الصوتية لإنجاز مجموعة واسعة من الأعمال، بدءاً من تنظيم المواعيد والبحث عن المعلومات، وصولاً إلى إدارة المهام المعقدة والتفاعل مع التطبيقات المختلفة.
وتأتي هذه التطورات في ظل منافسة قوية بين شركات التكنولوجيا الكبرى لتطوير مساعدين صوتيين أكثر ذكاءً، إذ تعمل شركات مثل Apple وAmazon على تحسين قدرات مساعديها الصوتيين، بينما تطور شركات ناشئة تقنيات جديدة تهدف إلى جعل المساعد الرقمي أكثر قدرة على فهم الإنسان والتفاعل معه.
وأوضحت OpenAI أن أكثر من 150 مليون مستخدم يعتمدون حالياً على ميزات Voice وDictation داخل ChatGPT، ما يعكس تزايد الطلب على أدوات الذكاء الاصطناعي الصوتية.
ورغم التطور الكبير في النماذج الجديدة، أقرت الشركة بأن التقنية لا تزال تحتاج إلى تحسينات إضافية. وخلال بعض العروض التجريبية ظهرت تحديات مرتبطة بالنطق واللهجات، حيث بدت بعض الترجمات الصوتية أقل طبيعية، كما ظهرت فروقات في جودة الأداء بين اللغات المختلفة.
وأكدت OpenAI أن النماذج الجديدة مدربة على دعم العديد من اللغات العالمية، لكنها أوضحت أن مستوى الدقة والطلاقة قد يختلف من لغة إلى أخرى، مع استمرار العمل على تحسين الأداء.
كما شددت الشركة على وجود أنظمة أمان Safety Systems مدمجة داخل المساعد الصوتي، بهدف تقديم ردود مناسبة للمستخدمين، خصوصاً المراهقين، والتعامل مع المحادثات الحساسة وفق ضوابط محددة.
وأكدت OpenAI أن الهدف من تطوير ChatGPT الصوتي هو تعزيز الإنتاجية وتسهيل الوصول إلى المعلومات والخدمات، وليس إنشاء علاقة عاطفية بديلة بين الإنسان والآلة، مشيرة إلى أن المساعد الذكي يبقى أداة تقنية مصممة لمساعدة المستخدم في أداء مهامه اليومية.
وُيمثل إطلاق GPT-Live-1 وGPT-Live-1 mini خطوة جديدة في سباق تطوير الجيل المقبل من المساعدين الذكيين، حيث تتجه الصناعة نحو أنظمة قادرة على الاستماع والفهم والتفاعل بطريقة أقرب إلى التواصل البشري الحقيقي.


